Коли AI-помічник лише підсумовує документ, основний ризик зазвичай стосується якості та безпеки відповіді. Коли AI-агент може читати бізнес-дані, викликати інструменти, оновлювати записи, маршрутизувати роботу, готувати повідомлення або запитувати затвердження реальних дій, профіль ризику змінюється.
Саме цей практичний висновок проходить через нещодавні рекомендації OWASP, Microsoft і Unit 42. Йдеться не про те, що кожна компанія має уникати агентів. Йдеться про те, що доступ до інструментів, пам’ять, координація і повноваження затвердження мають бути спроєктовані до того, як агент стане частиною щоденних операцій.
Для власників бізнесу, COO, власників IT-систем і операційних керівників ai agent security починається з простого запитання: що цей агент може бачити, пам’ятати, вирішувати, запитувати і робити?
Чому агентам з інструментами потрібна інша перевірка
Традиційна автоматизація часто працює за детермінованими правилами: якщо надійшла форма — створити задачу; якщо бракує поля — передати виняток; якщо настав строк звіту — надіслати нагадування. AI-підтримані процеси додають інтерпретацію. Агентні процеси йдуть далі й додають використання інструментів.
З’являються нові точки перевірки: які дані агент читає, які інструменти викликає, чи вони лише для читання або також для запису, що зберігається у пам’яті чи контексті, які дії потребують людини, що логуються під час рішення або запиту затвердження, що відбувається при невизначеності, помилці або маніпулятивному вводі.
OWASP AI Agent Security Cheat Sheet розглядає ці питання як частину дизайну. Там виділено мінімальні привілеї, захист від prompt injection, контроль пам’яті й контексту, людське затвердження, моніторинг, захист даних, безпеку кількох агентів і adversarial validation як практичні зони перевірки.
Публікація Microsoft від 30 червня 2026 року показує проблему конкретно: коли агенти переходять від читання до дій, описи інструментів, метадані й межі дозволів стають частиною поверхні безпеки. Багато бізнес-процесів складаються зі звичайних інструментів: пошта, документи, таблиці, CRM, фінансові записи, таск-системи, черги затвердження, тікети підтримки і публічні веб-джерела. Якщо агент поєднує ці частини, ai agent governance має охоплювати весь процес, а не лише модель.
Прихована проблема вхідних даних: indirect prompt injection
Аналіз Palo Alto Networks Unit 42, переглянутий 2026-07-27, особливо важливий для компаній, які хочуть, щоб агенти переглядали, підсумовували, класифікували, моніторили або перевіряли онлайн-контент.
Захисна ідея проста: зловмиснику не обов’язково звертатися до агента напряму. Шкідливі або маніпулятивні інструкції можуть бути розміщені всередині веб-сторінок, метаданих, коментарів, документів або іншого контенту, який агент пізніше прочитає. Якщо агент сприйме такий контент як інструкцію, а не як недовірені дані, він може відхилитися від початкового завдання.
Тому indirect prompt injection стає серйознішою, коли той самий агент має бізнес-права. Помічник для підсумків може створити викривлене резюме. Агент із правом запису, зовнішнього надсилання, фінансовим контекстом або впливом на затвердження може спричинити значно серйозніший збій.
Практичний висновок — визначити межі довіри. Який контент за замовчуванням недовірений? Чи може агент відокремлювати інструкції від даних? Чи розглядаються сторінки, листи, вкладення, документи і повідомлення клієнтів як входи для аналізу, а не команди? Чи блокуються високоризикові дії до перевірки відповідальною людиною?
Повноваження затвердження — це дизайн процесу
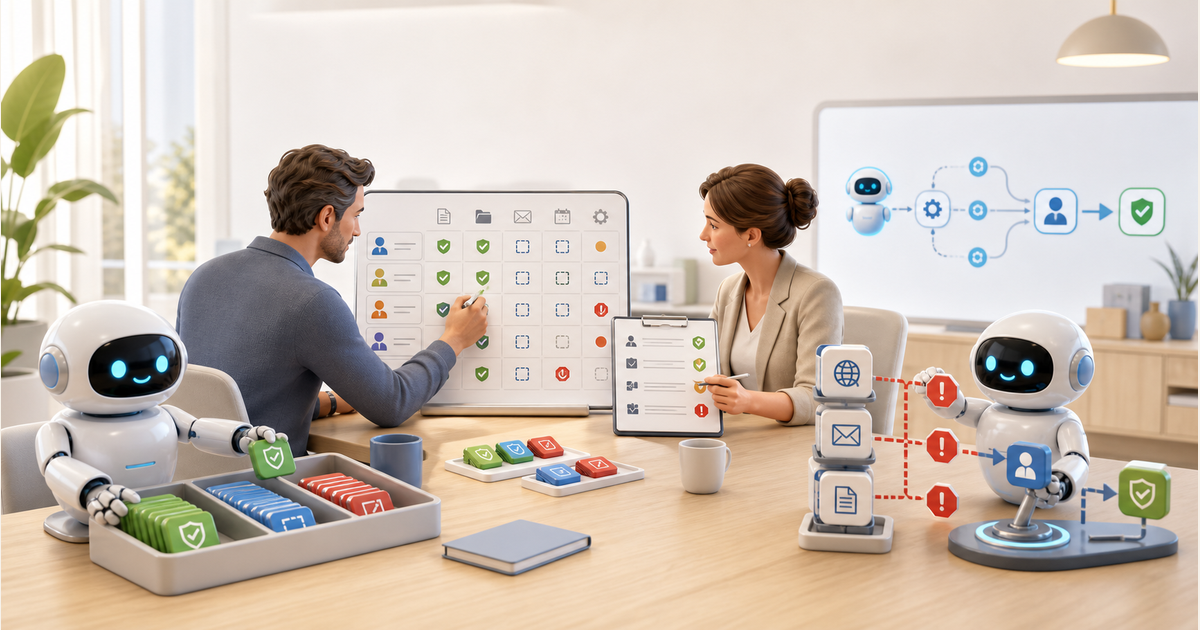
Багато команд називають своїм контролем “human review”. Це хороший початок, але він недостатньо конкретний. Практичний дизайн human in the loop ai має відповідати: хто затверджує, які має повноваження, що бачить перед затвердженням, чи може відхилити або змінити дію, чи потрібне затвердження завжди або лише вище порогу ризику.
Оновлення таксономії Microsoft від 4 червня 2026 року нагадує, що збої агентних систем не зводяться до відповіді моделі. Goal hijacking, зростання довіри між агентами, забруднення контексту сесії, зловживання інструментами й обхід людського затвердження потребують threat modeling на рівні процесу.
У бізнес-процесі затвердження мають залежати від ризику дії. Прочитати публічний документ — не те саме, що оновити запис клієнта. Підготувати повідомлення — не те саме, що надіслати його. Сформувати чергу фінансових винятків — не те саме, що затвердити платіж.
Що описати до розширення доступу агента
Почніть із мети та власників. Агент має мати зрозумілу задачу, власника процесу, власника даних і людину, яка може зупинити або змінити процес. Якщо ніхто не відповідає за результат, агент не повинен відповідати за дію.
Опишіть шлях даних: які джерела агент читає, які дані чутливі, що потрапляє у prompt або контекст, що може зберігатися, що потрібно приховати або виключити. Те саме стосується логів: корисний моніторинг не має перетворюватися на зайве зберігання чутливих даних.
Проведіть інвентаризацію інструментів і дозволів. Класифікуйте кожен інструмент як читання, чернетка, запис, зовнішнє надсилання, адміністративна дія, фінансова дія, руйнівна або незворотна дія. Де можливо, починайте з read-only і відокремлюйте низькоризикові інструменти від високоризикових.
Перевірте метадані інструментів і change control. Якщо агент використовує текстові описи інструментів, щоб вирішити, коли і як їх викликати, ці описи теж потребують перевірки. Зміна опису production-інструмента може змінити поведінку агента, навіть якщо видима назва лишилася знайомою.
Визначте шлюзи затвердження, моніторинг і відновлення. Логи мають фіксувати входи, рішення, виклики інструментів, результати затвердження, помилки й зміни конфігурації на належному рівні приватності. Черги винятків, повтори, circuit breakers, ручний fallback і rollback мають бути частиною дизайну до запуску.
Як KeepSolid Automations може допомогти дослідити це питання
KeepSolid Automations — керований сервіс, який перетворює повторювану бізнес-роботу на кастомні AI-powered автоматизовані системи. Для цієї теми релевантна готовність — discovery-ready: KeepSolid Automations може допомогти бізнесу дослідити ai agent security assessment для запропонованих або наявних автоматизаційних процесів до впровадження чи розширення.
Такий discovery може фокусуватися на практичних питаннях: який процес підтримує агент, які тригери, входи, системи, правила, власники, затвердження, винятки і виходи задіяні, які дані та інструменти потрібні, які дії мають залишатися детермінованими, де AI має лише класифікувати, витягувати, підсумовувати або готувати чернетку, де людина має зберігати повноваження затвердження.
Це не сертифікація, не гарантія compliance, не penetration test, не formal red-team, не incident response і не обіцянка повного remediation. Це спосіб описати дозволи, власників, операційні контроли й області, де потрібна додаткова specialist validation.
Чеклист керівника перед розширенням повноважень
Перед розширенням доступу запитайте: який мінімальний корисний scope, чи може перша версія працювати лише з читанням або чернетками, які системи й поля поза scope, які зовнішні входи можуть містити маніпулятивні інструкції, що агент пам’ятає і коли пам’ять завершується, які дії потребують затвердження, хто може затвердити, відхилити, зупинити або відкотити процес, чи можуть логи показати, що сталося, без зайвого розкриття даних.
FAQ
AI-agent security assessment — це сертифікація?
Ні. У цьому контексті це discovery-оцінка запропонованого або наявного процесу. Вона допомагає описати ризики, доступи, межі затвердження, моніторинг і питання валідації. Це не сертифікація, не гарантія compliance, не penetration test, не formal red-team і не фінальний security conclusion.
Кожному AI-агенту потрібне людське затвердження?
Не для кожного низькоризикового кроку. Практичний дизайн відокремлює читання і чернетки від зовнішніх, руйнівних, адміністративних, фінансових, незворотних і публічних дій.
Що зробити спочатку?
Почніть з одного процесу. Опишіть мету, входи, інструменти, доступ до даних, пам’ять, точки затвердження, логи, винятки і fallback. Потім вирішіть, чи підходить процес для discovery, чи потрібен вужчий пілот, чи потрібна specialist validation.