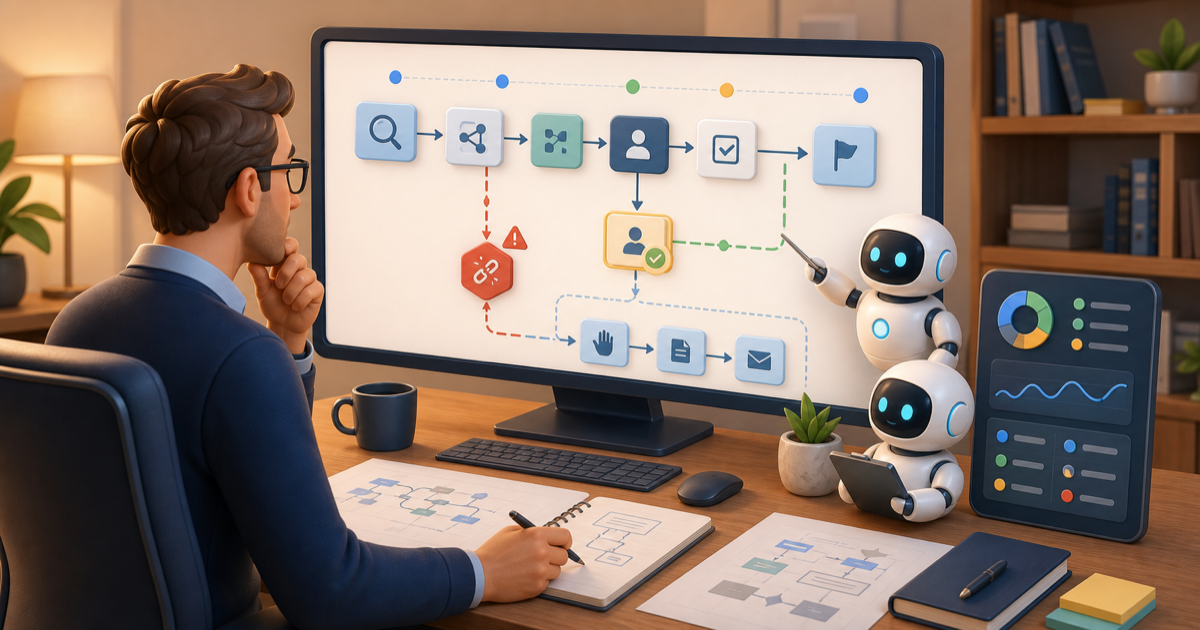
Багато команд не помічають крихкості робочого процесу одразу після його створення. Спочатку це може бути зручний спосіб передавати інформацію між кількома кроками, повідомляти відповідальну людину або підтримувати регулярне завдання. Згодом власник процесу змінює роль, облікові дані перестають працювати, поспіхом додається нове правило або двоє людей створюють логіку, що дублюється. Процес може продовжувати працювати — доки не зникає передача і ніхто не розуміє, з чого почати пошук.nnУ цей момент проблему варто розглядати як питання операційного процесу, а не лише як технічну несправність. Для керівника операцій automation rescue — це discovery-розмова про те, чи можна зрозуміти, протестувати й покращити крихкий процес між різними інструментами. Це не обіцянка перебудувати кожен процес. Спочатку потрібно зробити поточний процес достатньо прозорим для відповідального рішення.nn## Сигнали проблеми зазвичай проявляються в операційній роботіnnПроцес, який дає збій, рідко повідомляє про це зрозумілим повідомленням про помилку. Частіше симптоми видно в роботі навколо нього:nn- Завдання виконується двічі, бо дві гілки виглядають відповідальними за нього.n- Запит залишається без відповіді, бо тригер не дійшов до потрібної людини.n- Лише колишній працівник знає, навіщо існує певний крок.n- Ручний обхідний шлях стає звичним, але ніхто не фіксує, коли і чому його застосовують.n- Команди не можуть визначити, якому запису, статусу або повідомленню довіряти.nnЦе водночас питання відповідальності, дизайну процесу й автоматизації. Ініціатива business process automation найкорисніша, коли починається з реальної роботи: вхідних даних, правил, винятків, погоджень, людей і результатів, важливих для бізнесу.nn## Почні з workflow audit, а не з рішення перебудувати процесnnСфокусований workflow audit допомагає керівникам операцій структурувати процес до вибору рішення. Під час discovery можна описати наявні скрипти або кроки та визначити:nn- відповідального власника процесу і людей, які перевіряють винятки;n- тригер, що запускає кожен важливий шлях;n- необхідні облікові дані, дозволи та залежності;n- вихідні записи й очікувані результати;n- відомі збої, дубльовану логіку та ручні передачі;n- вартість або вплив на бізнес, якщо критичний шлях працює не так, як очікується.nnЦя робота має зберігати докази, а не покладатися на пам’ять. Наявні скрипти, сторінки процесів, повідомлення, вкладення та отримані матеріали слід вважати неперевіреними вхідними даними, доки їх не перегляне відповідальний власник.nnРезультат — не автоматичний план впровадження. Це спільна карта того, що процес робить зараз, що він має робити і де бізнесу потрібно прийняти рішення.nn## Перевірте основний шлях і сценарії, яких хотілося б уникнутиnnКоли процес стає видимим, потрібно зрозуміти, чи тестували критичний шлях у реалістичних умовах. Під час discovery можна визначити типові випадки:nn1. Нормальний випадок, коли очікувані дані та погодження надходять у потрібному порядку.n2. Виняток, коли дані неповні, суперечливі, затримуються або спрямовані не туди.n3. Відновлення, коли залежність недоступна або попередній крок потрібно перевірити й виконати повторно.nnТакі тести не гарантують відновлення чи безперервної роботи. Водночас вони допомагають відповідальному власнику зрозуміти, яким рішенням і передачам потрібні чіткіші правила до вибору реалізації.nn## Розглядайте workflow monitoring як питання дизайнуnnЯкщо збої залишаються непомітними, до обговорення часто входить workflow monitoring. Корисно питати не лише, чи можна додати моніторинг, а що саме має бачити відповідальна людина, щоб розпізнати суттєвий виняток і визначити наступний крок.nnЗалежно від процесу можна оцінити сигнали статусу, черги помилок, правила повторних спроб, ескалації, ліміти витрат або ручний fallback. Кожне рішення залежить від процесу, дозволів, даних, ризиків і людей, які ним керуватимуть. Це потрібно перевіряти для конкретного процесу, а не вважати стандартними функціями.nnЛюдська перевірка має залишатися обов’язковою. Для зовнішніх, руйнівних, адміністративних, фінансових, високоризикових або незворотних дій бізнес має визначити явне погодження, а не залишати дію без нагляду.nn## Зробіть workflow documentation корисною для наступного власникаnnЯкісна workflow documentation — це не лише схема, збережена після запуску. Вона має допомогти новому власнику відповісти на практичні питання:nn- Який бізнес-результат має підтримувати цей процес?n- Хто відповідає за процес, вихідні дані та рішення щодо винятків?n- Що його запускає, що він змінює і чого не має робити?n- Які вхідні дані, залежності, погодження та fallback потрібно перевірити?n- Де є докази винятку і хто може зупинити або змінити процес?nnФіксація цих відповідей робить можливим контроль змін і допомагає відрізняти звичайну операційну проблему від рішення, яке потребує ескалації.nn## Що може прояснити розмова про automation rescuennKeepSolid Automations може обговорити керований discovery-підхід для крихкого процесу. Така розмова допомагає оцінити поточний процес, описати його критичні шляхи й зрозуміти, чи можливий більш керований підхід.nnРезультатом може бути попередній план консолідації, перелік контролів для перевірки або рішення залишити частину кроків ручними, доки базовий процес не стане зрозумілішим. Реалізація залежить від інструментів клієнта, дозволів, даних, стабільності процесу, рівня ризику та вимог. До оцінки не слід припускати конкретну інтеграцію, модель розгортання, строки, результат відновлення або постійний рівень сервісу.nn## Поширені запитанняnn### Чи завжди business workflow automation є відповіддю, коли процес ламається?nnНі. Збій може вказувати на нечітку відповідальність, непослідовні правила або процес, який потрібно перепроєктувати. Оцінка допомагає визначити, де автоматизація доречна, а де має залишитися перевірка людиною.nn### Що керівнику операцій принести на оцінку?nnВласників процесу, приклади очікуваних і помилкових результатів, бізнес-правила, відомі залежності та наявні операційні нотатки. Мета — побудувати точну картину, а не захищати поточну схему.nn### Чи гарантує оцінка відновлення наявного процесу?nnНі. Оцінка допомагає виявити ризики, перевірити типові шляхи та підготувати варіанти. Будь-яка реалізація або відновлення залежать від результатів discovery та перевірки.nn## Почні з процесу, який ваша команда справді виконуєnnЯкщо процес між різними інструментами стало важко контролювати, пояснювати або відновлювати, почніть із розмови про керований discovery. KeepSolid Automations може допомогти оцінити процес, визначити питання, на які потрібні відповіді, і зафіксувати, де мають залишатися відповідальність та перевірка людиною до затвердження будь-яких змін.
Коли робочий процес між різними інструментами починає давати збій: як оцінити відновлення автоматизації
Непомітні збої, нечітка відповідальність і недокументовані передачі можуть перетворити корисний процес на операційний ризик. Розглянемо, як керівникам операцій оцінити крихкий процес між різними інструментами перед змінами.