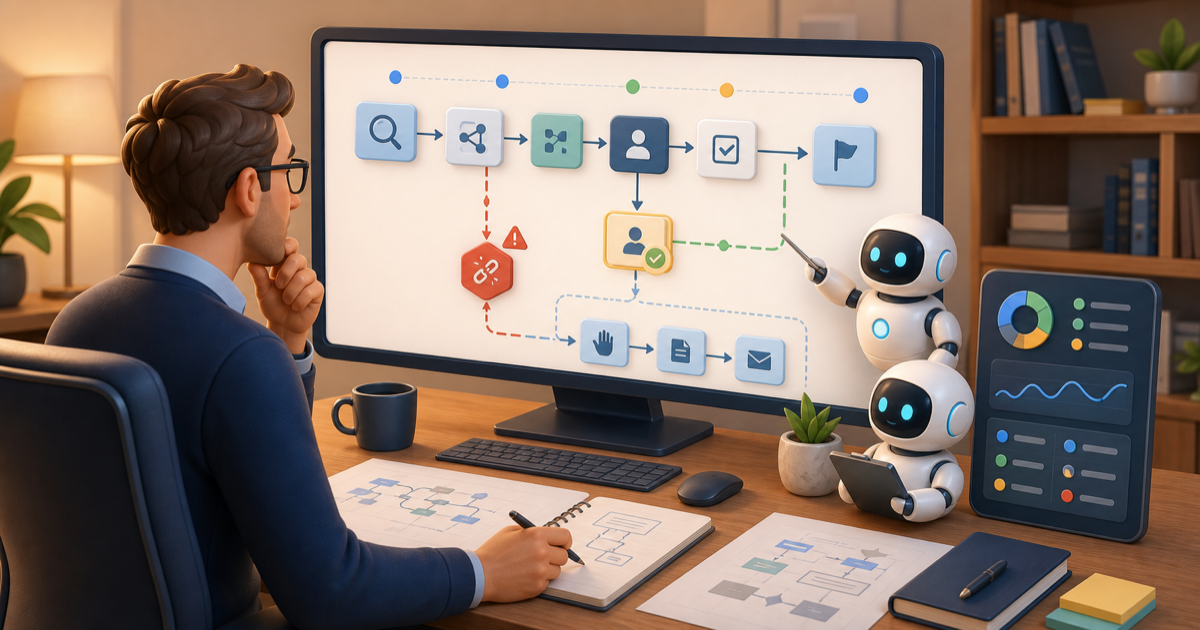
Многие команды не замечают хрупкость процесса в момент его создания. Сначала он может быть удобным способом передавать информацию между несколькими шагами, уведомлять сотрудника или поддерживать выполнение регулярной задачи. Со временем владелец процесса меняет роль, учетные данные перестают работать, в спешке добавляется новое правило или два человека создают пересекающуюся логику. Процесс может продолжать выполняться — пока не пропадет передача и никто не поймет, с чего начинать поиск причины.nnВ этот момент проблему важно рассматривать как вопрос операционного процесса, а не только как техническую неисправность. Для руководителя операций automation rescue — это discovery-разговор о том, можно ли понять, протестировать и улучшить хрупкий процесс между системами. Это не обещание, что любой процесс можно или нужно перестроить. Сначала нужно сделать текущую схему достаточно прозрачной для ответственного решения.nn## Сигналы проблемы обычно проявляются в операционной работеnnСбойный процесс редко сообщает о себе понятным сообщением об ошибке. Чаще симптомы видны в окружающей работе:nn- Задача выполняется дважды, потому что две ветки выглядят ответственными за нее.n- Запрос остается без ответа, потому что триггер не дошел до нужного человека.n- Только бывший сотрудник знает, зачем существует определенный шаг.n- Ручной обходной путь становится нормой, но никто не фиксирует, когда и почему его используют.n- Команды не могут договориться, какой документ, статус или сообщение считать достоверным.nnЭто одновременно проблемы ответственности, дизайна процесса и автоматизации. Инициатива business process automation полезнее всего, когда начинается с реальной работы: входных данных, правил, исключений, согласований, людей и результатов, важных для бизнеса.nn## Начните с workflow audit, а не с решения о перестройкеnnЦеленаправленный workflow audit помогает руководителям операций структурировать процесс до выбора решения. На этапе discovery можно составить перечень существующих скриптов или шагов и определить:nn- ответственного владельца процесса и людей, которые рассматривают исключения;n- триггер, запускающий каждый важный путь;n- необходимые учетные данные, разрешения и зависимости;n- исходные записи и ожидаемые результаты;n- известные сбои, дублирующуюся логику и ручные передачи;n- стоимость или влияние на бизнес, когда критический путь работает не так, как ожидается.nnВажно сохранять доказательства, а не полагаться на память. Существующие скрипты, страницы процессов, сообщения, вложения и полученные материалы следует считать непроверенными входными данными, пока их не просмотрит ответственный владелец.nnРезультат — не автоматический план внедрения. Это общая карта того, что процесс делает сейчас, что он должен делать и где бизнесу нужно принять решение.nn## Проверьте основной путь и сценарии, которых хотелось бы избежатьnnПосле того как процесс стал видимым, нужно понять, тестировался ли критический путь в реалистичных условиях. В discovery можно определить типовые случаи:nn1. Нормальный случай, когда ожидаемые данные и согласование приходят в нужном порядке.n2. Исключение, когда данные неполные, противоречивые, задерживаются или направляются не туда.n3. Восстановление, когда зависимость недоступна или предыдущий шаг нужно проверить и выполнить повторно.nnТакие тесты не гарантируют восстановление или бесперебойную работу. Но они помогают ответственному владельцу понять, каким решениям и передачам нужны более четкие правила до выбора реализации.nn## Рассматривайте workflow monitoring как вопрос проектированияnnЕсли сбои остаются незаметными, в обсуждение часто входит workflow monitoring. Полезно спрашивать не о том, можно ли добавить мониторинг вообще, а о том, что должен видеть ответственный человек, чтобы распознать существенное исключение и решить, что делать дальше.nnВ зависимости от процесса можно оценить статусы, очереди ошибок, правила повторных попыток, эскалации, ограничения затрат или ручной fallback. Эти решения зависят от процесса, разрешений, данных, рисков и людей, которые будут им управлять. Их нужно проверять для конкретного процесса, а не считать стандартными функциями.nnЧеловеческая проверка здесь обязательна. Для внешних, разрушительных, административных, финансовых, высокорисковых или необратимых действий нужно определить явное согласование, а не оставлять их без присмотра.nn## Сделайте workflow documentation полезной следующему владельцуnnХорошая workflow documentation — это не просто схема, сохраненная после запуска. Она должна помогать в сложной ситуации ответить на практические вопросы:nn- Какой бизнес-результат должен поддерживать процесс?n- Кто отвечает за процесс, исходные данные и решения по исключениям?n- Что его запускает, что он изменяет и чего не должен делать?n- Какие входные данные, зависимости, согласования и fallback нужно проверить?n- Где находится доказательство исключения и кто может остановить или изменить процесс?nnТакая документация делает возможным контроль изменений и помогает отличить обычную операционную проблему от решения, требующего эскалации.nn## Что может прояснить разговор об automation rescuennKeepSolid Automations может обсудить управляемый discovery-подход для хрупкого процесса. Это помогает оценить текущий процесс, описать его критические пути и понять, реалистичен ли более управляемый способ работы.nnРезультатом может стать предварительный план консолидации, перечень контролей для проверки или решение оставить часть шагов ручными, пока процесс не станет понятнее. Возможность реализации зависит от инструментов клиента, разрешений, данных, стабильности процесса, уровня риска и требований. До оценки нельзя предполагать конкретные интеграции, способ развертывания, сроки, результат восстановления или постоянный уровень сервиса.nn## Частые вопросыnn### Всегда ли business workflow automation — ответ на сбой процесса?nnНет. Сбой может указывать на неясную ответственность, несогласованные правила или необходимость перепроектировать сам процесс. Оценка помогает определить, где автоматизация уместна, а где должна остаться проверка человеком.nn### Что руководителю операций принести на оценку?nnВладельцев процесса, примеры ожидаемых и ошибочных результатов, бизнес-правила, известные зависимости и существующие операционные заметки. Цель — построить точную картину, а не защищать текущую схему.nn### Гарантирует ли оценка восстановление существующего процесса?nnНет. Оценка помогает выявить риски, проверить типовые пути и подготовить варианты. Любая реализация или восстановление зависят от результатов discovery и последующей проверки.nn## Начните с процесса, который действительно выполняет ваша командаnnЕсли процесс между системами стало трудно контролировать, объяснять или восстанавливать, начните с разговора о managed discovery. KeepSolid Automations может помочь оценить процесс, определить вопросы, на которые нужны ответы, и зафиксировать, где должны сохраняться ответственность и проверка человека до утверждения любых изменений.
Когда межсистемный рабочий процесс начинает давать сбои: как оценить возможность восстановления автоматизации
Скрытые сбои, неясная зона ответственности и недокументированные передачи могут превратить полезный процесс в операционный риск. Разбираем, как руководителям операций оценить хрупкий процесс между системами до принятия решения об изменениях.